Рост нагрузки часто подталкивает команду к очевидным решениям: увеличить сервер, добавить ноды, перейти на Kubernetes или начать перестраивать архитектуру. Проблема в том, что реальное узкое место веб-сервиса может находиться в базе данных, локальном состоянии, повторных запросах или внешнем API. Дополнительные ресурсы в таком случае не выход.
На примере билетной системы разбираем, как искать предел производительности, готовить веб-приложение к горизонтальному масштабированию и выбирать изменения, которые дают запас под высокую нагрузку без дорогой перестройки всей системы.
24 октября 2024 года в 14:59:45 билетный виджет одной из крупнейших билетных систем получил первую ошибку от шлюза Московского академического Музыкального театра. Через 15 секунд началась продажа билетов.
Следующие 33 минуты шлюз почти не отвечал. В логах накопилось около 10 900 ошибок — по 300–500 в минуту. Примерно 90% из них возникли при загрузке схемы зала. Ошибку вместо неё получили 759 IP-адресов.
Проблема затронула и оплаченные заказы. Шлюз не подтвердил 271 продажу с первого раза. Позже эти операции восстановил крон, но в момент покупки зрители не знали, получили они билеты или нет.
Первой реакцией было добавить системе ресурсов. Мы увеличили тайм-ауты, подняли лимиты PHP-FPM и PostgreSQL. Это не помогло: узкое место находилось за пределами нашей инфраструктуры.
Почему увеличение ресурсов не сняло узкое место
Количество пользователей само по себе мало говорит о нагрузке. Один человек читает новость, другой загружает большой файл, третий покупает билет одновременно с тысячами зрителей. Нагрузку создают конкретные операции, частота их выполнения и время обработки.
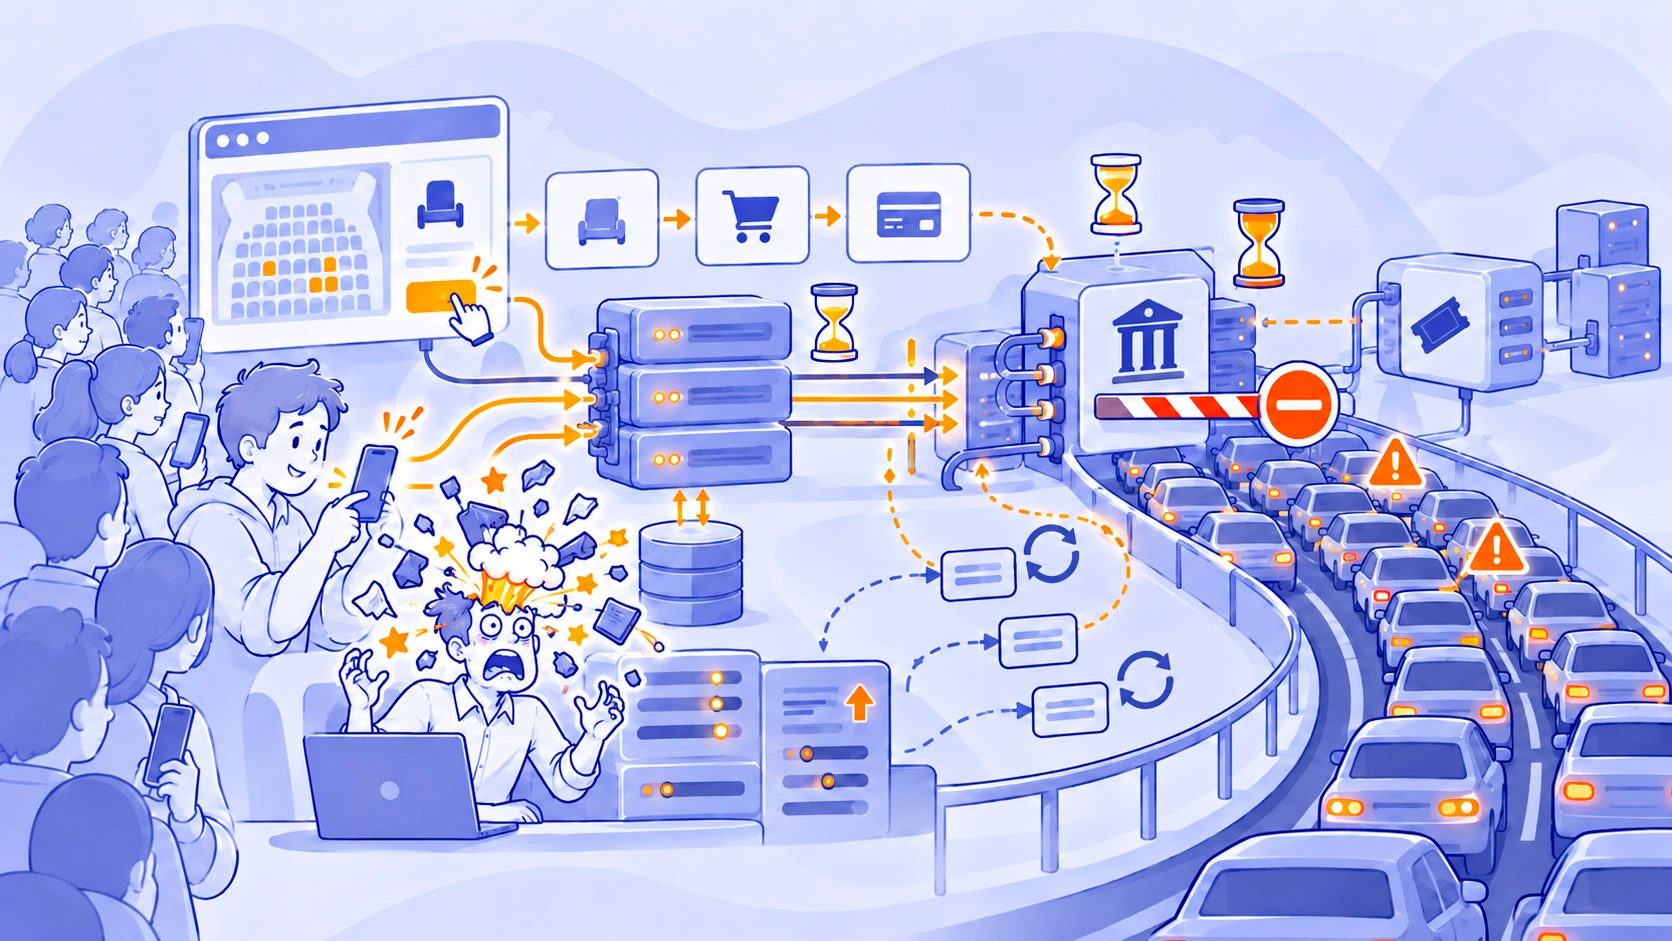
В билетной системе зритель сначала открывает виджет и запрашивает схему зала. Затем выбирает место, создает предварительное бронирование, оформляет заказ и оплачивает его.
Приложение выполняет часть этих операций через синхронные обращения к SOAP-шлюзу театра. У некоторых площадок шлюз передаёт запрос дальше, в другую билетную систему.
Пока внешний сервис не ответит, PHP-воркер ждёт. На каждый вызов было отведено семь секунд. Во время инцидента мы увеличили тайм-аут до 15 секунд: рассчитывали дать внешней системе больше времени на ответ. В результате воркеры дольше оставались занятыми, а пропускная способность приложения снижалась.

Увеличение лимитов PHP-FPM и PostgreSQL тоже не изменило ситуацию. Наше приложение могло принять больше запросов, но все они продолжали приходить в один SOAP-шлюз с ограниченной пропускной способностью. Мы расширяли дорогу перед закрытым шлагбаумом.
Дополнительную нагрузку создавали повторные попытки. Очереди перед шлюзом не было. Ограниченного механизма повторов тоже. Если зритель обновлял страницу, приложение запускало ещё один синхронный вызов.
Первым узким местом оказался внешний компонент, которым мы не управляли.
Как сократили нагрузку на внешний API
После первого инцидента мы начали с самого дешёвого изменения — сокращения количества обращений к шлюзу.
Схема зала меняется редко, поэтому время её хранения в кеше увеличили с пяти минут до часа.
Одного увеличения TTL было недостаточно. После истечения кеша сотни пользователей могли одновременно запросить обновление и создать новый всплеск обращений к внешней системе.
Мы добавили распределенную блокировку. Первый запрос обновлял данные, остальные пользователи продолжали получать предыдущую корректную версию схемы. Если шлюз возвращал ошибку, пустой ответ в кеш не попадал.
В результате приложение стало значительно реже обращаться к ограниченному внешнему ресурсу. Это дало системе дополнительный запас и одновременно показало следующую проблему: веб-приложение было плохо подготовлено к горизонтальному масштабированию.
Горизонтальное масштабирование показало размер технического долга
К концу 2025 года сервис снова готовили к крупным стартам продаж. Сначала увеличили мощность основной машины. Затем подняли вторую PHP-ноду для трафика МХТ имени Чехова.
Nginx направлял на неё часть запросов театра. Файлы синхронизировались через rsync раз в две минуты. Лимит соединений с базой увеличили до 400.
Вторая нода работала, но полноценно разгрузить систему не могла. Часть запросов уходила на новую машину, а корзина и заказы оставались на основной. Сессии, кеш и блокировки хранились в локальных файлах, поэтому вторая нода их не видела.
Обе машины продолжали обращаться к одному SOAP-шлюзу. Добавление экземпляров приложения потенциально увеличивало число потребителей ресурса с фиксированной пропускной способностью.
Именно здесь технический долг начал определять стоимость дальнейшего масштабирования.
Сам шлюз перегружался независимо от нашего кода. При этом накопленные ограничения приложения мешали построить систему вокруг этого ограничения:
- - состояние хранилось на локальном диске;
- - кеширование было распределено по крупным классам интеграции;
- - модули шлюза, заказа и оплаты сильно зависели друг от друга;
- - критический путь покупки не покрывали автотесты;
- - релизы выполнялись вручную без быстрого отката;
- - данных о поведении системы под высокой нагрузкой было недостаточно.
Технический долг редко становится единственным источником проблем. Его стоимость проявляется в момент, когда системе требуется следующий шаг. В нашем случае внешний шлюз достиг предела первым, а состояние приложения определило объём работы, необходимый для полноценного горизонтального масштабирования.
Как подготовили веб-приложение к нескольким нодам
В феврале 2026 года мы разобрали накопленные ограничения системы.
Во время мартовского старта продаж МХТ нагрузка достигла 578 соединений в секунду к PHP-FPM. Процессоры, память и база данных на нашей стороне работали без аномалий. Ошибки снова приходили от шлюза театра.
Задачей следующего этапа стала изоляция трафика отдельных площадок и полноценное использование дополнительных нод.

Файловый кеш и сессии перенесли в Redis. Одновременно переработали маршрутизацию всех 73 методов API. После этого запросы конкретного театра можно было целиком направить на отдельную машину.
Ещё одно ограничение находилось во фронтенде. Билетный виджет работает внутри iframe на сайтах театров. Браузер мог блокировать сторонние cookie, поэтому каждое открытие окна создавало новую сессию и ещё 3–5 запросов.
Сессию перенесли в localStorage, а обмен между сайтом и iframe организовали через postMessage.
Изменения вышли в продакшен 7 апреля 2026 года.
Что изменилось после масштабирования
Старты продаж с апреля по август 2026 года прошли без новых инцидентов. Приложение получило возможность работать на нескольких нодах, а трафик отдельных театров стало возможно изолировать.
При этом у нас пока нет оснований считать найденный запас гарантированным пределом системы.
Регулярных нагрузочных тестов на проекте нет. Максимальная пропускная способность после изменений не измерена. Полная наблюдаемость тоже пока не построена: есть Zabbix и логи, но нет единой системы алертов и отдельных проверок состояния компонентов.
Поэтому команда продолжила искать следующее ограничение на рабочих данных.
Новая метрика показала, что на одну корзину приходится в среднем 3,25 предрезерва при одном необходимом. Медиана составляла три вызова, максимум — семь. Около 51% обращений оказались лишними. На ожидание шлюза одна пользовательская сессия тратила в среднем 4,8 секунды.
В корзину добавили признак изменения данных, чтобы запускать перебронирование только при необходимости. На фронтенде начали объединять дублирующие запросы.
Работа заняла 29 часов. Расчетный эффект — сокращение числа предрезервов примерно на 49%.
Это пока прогноз. Следующий сопоставимый пик позволит измерить результат и увидеть новое узкое место.
Как масштабировать веб-сервис: рабочая последовательность
В билетной системе заказчика часть этапов пришлось проходить уже после возникновения проблемы. Из этого опыта получилась последовательность, которую можно использовать при подготовке веб-сервисов и веб-приложений к росту нагрузки.
1. Описать критический пользовательский сценарий
Прогноз «аудитория вырастет до миллиона человек» почти бесполезен для разработки.
Нужно понимать, сколько пользователей одновременно откроют страницу, запросят данные, добавят товар или билет в корзину и перейдут к оплате.
Для каждой операции важны:
- - частота выполнения;
- - время обработки;
- - объём данных;
- - внешние зависимости;
- - допустимое время ответа;
- - стоимость ошибки.
Так абстрактный прогноз роста превращается в модель нагрузки, которую уже можно анализировать.
2. Найти первое измеримое узкое место
Предел системы может находиться в приложении, базе данных, очереди, файловом хранилище, сети или партнерском API.
Диагноз должен опираться на метрики и логи. Подозрительный компонент на архитектурной схеме ещё ничего не доказывает.
Нужно определить, какой ресурс достигает предела первым и что происходит с остальной системой в этот момент.
3. Убрать лишнюю работу
Перед покупкой новых ресурсов стоит проверить, сколько текущей нагрузки система создает сама.
Один тяжёлый запрос, короткий кеш или повторное выполнение операции способны потреблять больше ресурсов, чем весь остальной пользовательский сценарий.
В первую очередь стоит проверить:
- - планы запросов;
- - объём ответов;
- - лишние обращения к базе;
- - повторные вызовы внешних систем;
- - работу кеша;
- - тайм-ауты;
- - механизм повторных попыток;
- - дублирующие запросы с фронтенда.
Обработка запроса всегда дороже его отсутствия. Поэтому сокращение лишней работы часто даёт запас быстрее увеличения инфраструктуры.
4. Снять технический долг, который мешает следующему шагу
Полный рефакторинг системы редко нужен перед ближайшим пиком. Приоритет получает технический долг, который блокирует конкретное изменение.
Если сервису нужны дополнительные экземпляры, сначала проверяют локальные сессии, файлы и блокировки.
Если сбой распространяется каскадом, разбирают тайм-ауты и повторные запросы.
Если команда не понимает причину деградации, добавляют метрики, логи и алерты.
Так технический бэклог связывается с конкретным ограничением системы и прогнозом бизнеса.
5. Добавить вычислительные ресурсы
Вертикальное масштабирование часто даёт быстрый запас: больше процессоров, памяти, соединений или производительности диска.
Горизонтальное масштабирование добавляет новые экземпляры приложения и распределяет между ними трафик.
Перед запуском дополнительных нод нужно проверить:
- - где хранятся сессии и кеш;
- - есть ли локальные файлы и блокировки;
- - сколько соединений получит база данных;
- - какие лимиты действуют у внешних сервисов;
- - можно ли полностью направить отдельный пользовательский сценарий на конкретную ноду;
- - какой общий ресурс продолжат использовать все экземпляры.
Каждая новая нода должна увеличивать пропускную способность критического сценария. Если все экземпляры упираются в один ограниченный ресурс, масштабирование приложения может приблизить перегрузку этого ресурса.
6. Усложнять архитектуру после подтверждения необходимости
Шардинг, микросервисы, очереди и Kubernetes решают конкретные проблемы. Вместе с ними появляются новые требования к развёртыванию, наблюдаемости, восстановлению и компетенциям команды.
Медленный запрос после переезда в кластер останется медленным. Перегруженный внешний сервис продолжит получать запросы. Проблемная модель данных потребует сопровождения уже в более сложной инфраструктуре.
Архитектурное изменение имеет смысл, когда команда знает текущий предел, понимает следующий и может объяснить, какую проблему решает выбранная технология.
Как не переплатить за инфраструктуру и архитектуру
В феврале 2026 года полную программу выхода билетной системы из легаси оценили примерно в 890 часов. В неё вошли очереди, объектное хранилище, переработка интеграции, наблюдаемость и другие изменения.
Реализация всей программы сразу не соответствовала срокам ближайшего риска. Следующий крупный старт продаж наступал раньше окончания такой переделки, а часть задач практически не влияла на предстоящий пик.
Поэтому мы выбрали блок с Redis и изоляцией трафика. Фактическая работа заняла около 30–40 часов. Весь путь от анализа до выхода в продакшен — примерно шесть недель.
Очередь перед шлюзом, объектное хранилище и большая программа рефакторинга остались в техническом бэклоге. Постоянные расходы на инфраструктуру после изменений не выросли.
Параллельно заказчик рассматривал Kubernetes с автоматическим масштабированием. Только обязательные изменения в приложении оценили в 80–102 часа, без учёта настройки и дальнейшего сопровождения кластера.
Kubernetes позволил бы быстрее добавлять новые ноды. Все эти ноды при текущей архитектуре продолжили бы обращаться к тому же шлюзу театра.
В результате перед следующим пиком больший эффект давал короткий список изменений:
- - проверка тайм-аутов банков и Elasticsearch;
- - явная настройка пула PHP-FPM;
- - проверка кеша схемы зала;
- - гарантированное снятие блокировки заказа;
- - сокращение лишних вызовов шлюза.
Этот блок оценили в 12–20 часов. Он закрывал уже измеренные проблемы и не создавал новых постоянных расходов.
Поэтому стоимость масштабирования нельзя оценивать только стоимостью серверов или разработки.
Для каждого варианта лучше сравнивать:
- - срок внедрения;
- - разовые затраты;
- - постоянные расходы;
- - ограничение, которое решение снимает;
- - ожидаемый запас производительности;
- - срок, на который этого запаса хватит;
- - следующее вероятное узкое место;
- - стоимость сбоя, если ничего не менять.
Полугодовой архитектурный проект не спасёт сервис, который достигнет предела через два месяца. Сначала можно получить ограниченный запас под ближайший прогноз, а крупные изменения готовить следующим этапом.
Чек-лист подготовки веб-сервиса к высокой нагрузке
1. Как именно придёт новая нагрузка
Общие планы по росту пользователей дают слишком мало информации. Нужен сценарий с конкретными операциями, их количеством и скоростью появления.
2. Какой компонент достигнет предела первым
CPU, память и число серверов — только часть системы. Нужно проверить базу данных, очереди, блокировки, файловое состояние, сеть и внешние сервисы.
3. Какие ресурсы остаются общими для всех нод
Несколько экземпляров приложения могут одновременно использовать одну базу, один шлюз или одно хранилище. Такой общий ресурс способен стать следующим пределом системы.
4. Как настроены тайм-ауты и повторные запросы
Длинный тайм-аут удерживает рабочие процессы. Повторы на нескольких уровнях способны создать вторую волну нагрузки поверх исходного пика.
5. Какие функции можно временно отключить
Во время перегрузки приоритет получают операции, связанные с деньгами и сохранностью данных. Второстепенные расчеты, рекомендации и отчеты можно выполнять позже.
6. Как восстанавливаются незавершённые операции
Оплата может пройти, а подтверждение заказа потеряться. Для восстановления нужны идентификатор операции, явный статус и понятный порядок сверки.
7. Когда замораживать релизы
Крупные продажи, рекламные кампании и другие прогнозируемые пики стоит вносить в технический календарь. Перед ними команда проверяет запас системы и ограничивает изменения в критических компонентах.
8. Как измерить эффект каждого изменения
После каждой доработки нужно зафиксировать ожидаемый новый предел, следующее узкое место и срок, на который должно хватить полученного запаса.
Без повторного измерения оптимизация превращается в предположение.
Частые вопросы о масштабировании веб-сервисов
Что считать высокой нагрузкой для веб-сервиса?
Универсального количества пользователей или запросов нет. Высокая нагрузка начинается там, где один из компонентов системы приближается к своему пределу и начинает влиять на скорость, стабильность или выполнение критических операций.
Поэтому полезнее измерять конкретные сценарии: запросы в секунду, время выполнения операций, число соединений, обращения к внешним системам и потребление ограниченных ресурсов.
Когда нужно горизонтальное масштабирование?
Горизонтальное масштабирование полезно, когда дополнительный экземпляр приложения действительно увеличивает пропускную способность системы.
Перед добавлением нод нужно вынести общее состояние из локальных файлов, проверить сессии, кеш, блокировки, базу данных и внешние сервисы. Общий ограниченный ресурс может свести эффект дополнительных экземпляров к минимуму.
Поможет ли Kubernetes выдержать высокую нагрузку?
Kubernetes упрощает управление экземплярами приложения и автоматическое масштабирование, но сам по себе не устраняет узкие места в коде, базе данных или внешних интеграциях.
Сначала нужно определить ограничение системы. После этого становится понятно, какую часть проблемы решит оркестрация и оправданы ли затраты на её внедрение и поддержку.
Нужны ли нагрузочные тесты перед ростом трафика?
Да, если требуется заранее подтвердить конкретную пропускную способность системы.
Рабочие метрики показывают поведение сервиса под уже возникшей нагрузкой. Нагрузочное тестирование позволяет воспроизвести сценарий заранее, измерить предел и проверить поведение системы при деградации компонентов.
В нашем проекте регулярных нагрузочных тестов пока нет, поэтому подтверждённый предел после изменений остаётся неизвестным. Это одно из ограничений текущего результата.
Масштабирование веб-сервиса — это управление пределами
У любого веб-сервиса есть предел. При достаточной нагрузке закончится производительность базы, заполнится очередь, исчерпается пул соединений или перестанет отвечать внешний API.
Задача команды — заранее увидеть ближайшее ограничение, понять последствия его достижения и выбрать изменение с приемлемой стоимостью.
После изменений билетная система клиента получила возможность работать на нескольких нодах, изолировать трафик отдельных театров и сократить зависимость от лишних обращений к внешнему шлюзу. Оставшиеся ограничения при этом никуда не исчезли — теперь команда знает о них и может планировать следующие шаги на основе данных.
Это меняет сам принцип выбора технического решения. Варианты можно сравнивать по сроку внедрения, стоимости, снижению риска, постоянным расходам и запасу производительности, который они дают.
В SVK.Digital при разработке веб-приложений мы разделяем такую работу на два горизонта: изменения до ближайшего пика и решения, которые понадобятся при дальнейшем росте.
Архитектура становится управляемой, когда команда может назвать ближайшее узкое место, план его устранения, стоимость изменений и ожидаемый запас системы.